Бенчмарк Humanity's Sixth Sense показал: ИИ видит картинку, но не понимает сцену
iXBT.com ·
Исследовательское подразделение Scale Labs совместно со стартапом бывшего исследователя Google DeepMind Elorian представило бенчмарк Humanity's Sixth Sense — инструмент для проверки способности ИИ считывать неявные сигналы в изображениях и видео. Тест состоит из 522 заданий, разбитых на 288 статичных сцен и 234 видеофрагмента. Моделям задают вопросы, которые человек решает интуитивно: пройдёт ли автомобиль в зазор между припаркованными машинами, кто в комнате обладает негласной властью, каковы намерения человека в кадре.
Исследовательское подразделение Scale Labs совместно со стартапом бывшего исследователя Google DeepMind Elorian представило бенчмарк Humanity's Sixth Sense — инструмент для проверки способности ИИ считывать неявные сигналы в изображениях и видео. Тест состоит из 522 заданий, разбитых на 288 статичных сцен и 234 видеофрагмента. Моделям задают вопросы, которые человек решает интуитивно: пройдёт ли автомобиль в зазор между припаркованными машинами, кто в комнате обладает негласной властью, каковы намерения человека в кадре.
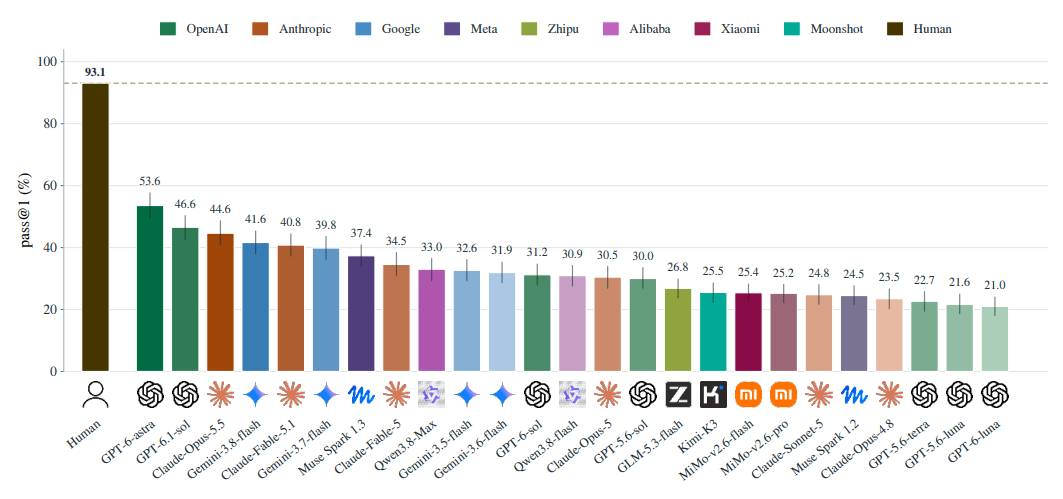
Результаты испытаний 25 актуальных мультимодальных моделей зафиксировали радикальный разрыв с человеком. Контрольная группа людей набрала 93,1% точности. Лидер среди моделей, GPT-6 Astra, показала 53,6%. GPT-6.1 Sol остановился на 46,6%, Claude Opus 5.5 — на 44,6%. Медиана по выборке составила 30,9%. Иными словами, лучшая доступная модель отвечает на вопросы чуть лучше случайного выбора.
Детальный анализ более 8 500 неудачных ответов вскрыл корень проблемы. 94% ошибок вызваны не слабостью рассуждений, а особенностью машинного зрения: модель просто не замечает визуальные маркеры и теряет контекст. На ошибки логики пришлось всего 5%. Попытки лечить проблему наращиванием вычислительного бюджета — в среднем 4 000 токенов на ответ — не сработали, а в отдельных случаях даже ухудшали точность. Эмуляция фокусировки через обрезание кадров дала минимальный эффект.
Вывод Scale Labs жёсткий: масштабирование логического вывода не компенсирует архитектурных ограничений базового компьютерного зрения.