Учёные улучшили реконструкцию увиденных человеком изображений по активности мозга
iXBT.com ·
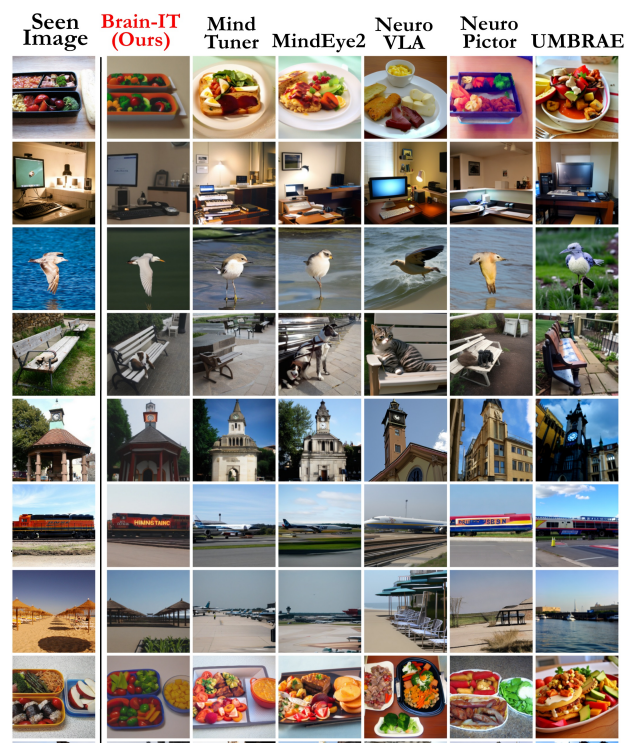
Учёные разработали ИИ-модель Brain-IT, которая восстанавливает изображения, увиденные человеком, по данным функциональной МРТ (fMRI). Главная проблема предыдущих методов заключалась не столько в способности получить правдоподобное изображение, сколько в его соответствии реальному: диффузионная модель могла правильно определить предметы, но ошибиться с расположением объектов, цветами и другими деталями. В Brain-IT специально разделили эти два типа информации.
Учёные разработали ИИ-модель Brain-IT, которая восстанавливает изображения, увиденные человеком, по данным функциональной МРТ (fMRI). Главная проблема предыдущих методов заключалась не столько в способности получить правдоподобное изображение, сколько в его соответствии реальному: диффузионная модель могла правильно определить предметы, но ошибиться с расположением объектов, цветами и другими деталями. В Brain-IT специально разделили эти два типа информации.
В основе модели лежит преобразование активности мозга в компактное представление. Авторы сводят около 40 тысяч вокселей — объёмных элементов данных fMRI — к 128 функциональным кластерам. В один кластер попадают воксели с похожими функциональными характеристиками. Каждый кластер затем превращается в Brain Token — представление содержащейся в нём информации, с которым уже работает Transformer.
Дальше Brain-IT извлекает из этих токенов два разных набора визуальных признаков. Первый описывает смысл изображения и подаётся на вход диффузионной модели чтобы определить, какие объекты и сцены должна получиться. Второй содержит низкоуровневую визуальную информацию — прежде всего общую структуру и расположение элементов. По этим признакам система сначала восстанавливает грубый вариант изображения, который затем становится начальной точкой для диффузионной генерации.
Такой подход нужен потому, что одна только семантическая информация недостаточна для точной реконструкции. Диффузионная модель может создать изображение, соответствующее смыслу, но изменить композицию или цвета. Brain-IT сначала фиксирует грубую структуру, а затем уточняет её под воздействием семантических признаков. По данным авторов, объединение двух веток логики работы даёт более точное соответствие исходному изображению, чем использование каждой из них отдельно.
Для проверки модели использовали Natural Scenes Dataset — набор данных fMRI восьми человек, которым показывали разнообразные фотографии. В основном сравнении Brain-IT превзошла предыдущие методы по 7 из 8 используемых метрик. Например, значение SSIM, характеризующее структурное сходство изображений, составило 0,486 против 0,431 у предыдущего лучшего результата MindEye2, а корреляция пикселей выросла до 0,386 против 0,322.
Особенно заметным оказался результат при задействовании модели с данными fMRI нового человека. Авторы отмечают, что результат сопоставим с показателями предыдущих методов, обучавшихся на полном наборе из 40 часов данных, при 1 часе fMRI у Brain-IT.
Авторы также проверили, насколько модель сохраняет работоспособность при ещё меньшем количестве данных. Качественные реконструкции удалось получить при 30 и 15 минутах данных нового участника: исследователи называют это первым, по их данным, случаем получения реконструкций такого качества при 15-минутной записи. Однако эти результаты не означают, что система способна буквально «прочитать картинку из мозга» за 15 минут: качество реконструкций остаётся ограниченным, а отдельные объекты и детали могут восстанавливаться неправильно.
Примечательно, что анализ работы механизма внимания Brain-IT показал специализацию отдельных токенов. Разные токены систематически вносили вклад в разные области предсказываемого изображения, а некоторые преимущественно были связаны с семантически значимыми областями вроде лиц, конечностей или текста. Пока что это скорее свойство работы модели, чем готовая новая карта зрительной коры.
Важно, что Brain-IT не превращает fMRI в точную видеозапись активности мозга. Задача модели гораздо конкретнее: извлечь из ограниченного и шумного сигнала достаточно информации, чтобы отдельно восстановить содержание изображения и его структуру, а затем объединить их с помощью генеративной модели.