Xiaomi выпустила ИИ-модель для таблиц, которая работает без дообучения
iXBT.com ·
Xiaomi-TabLDM умеет предсказывать значения для новых строк, используя размеченные данные как контекст: отдельно обучать модель под каждую задачу не требуется. Компания выпустила два варианта — классификатор на 70 млн параметров и регрессор на 71 млн. При прогнозировании модель по умолчанию объединяет результаты восьми прогонов с разным перемешиванием признаков и предобработкой данных. Она рассчитана на таблицы от сотен до десятков тысяч строк и от нескольких до более чем ста столбцов.
Xiaomi-TabLDM умеет предсказывать значения для новых строк, используя размеченные данные как контекст: отдельно обучать модель под каждую задачу не требуется. Компания выпустила два варианта — классификатор на 70 млн параметров и регрессор на 71 млн. При прогнозировании модель по умолчанию объединяет результаты восьми прогонов с разным перемешиванием признаков и предобработкой данных. Она рассчитана на таблицы от сотен до десятков тысяч строк и от нескольких до более чем ста столбцов.
Архитектура модели включает 3 этапа. Сначала она кодирует группы столбцов с помощью Set Transformer, затем собирает их представления в вектор строки, а после обрабатывает строки в контексте обучающих примеров. При этом тестовые строки могут обращаться к обучающим, но не друг к другу. В последних восьми блоках используется смесь экспертов, в которой для каждого токена выбирается один из двух маршрутизируемых экспертов и общий эксперт. Для ускорения повторных запросов предусмотрен KV-кэш, а крупные таблицы можно размещать в оперативной памяти или на диске.
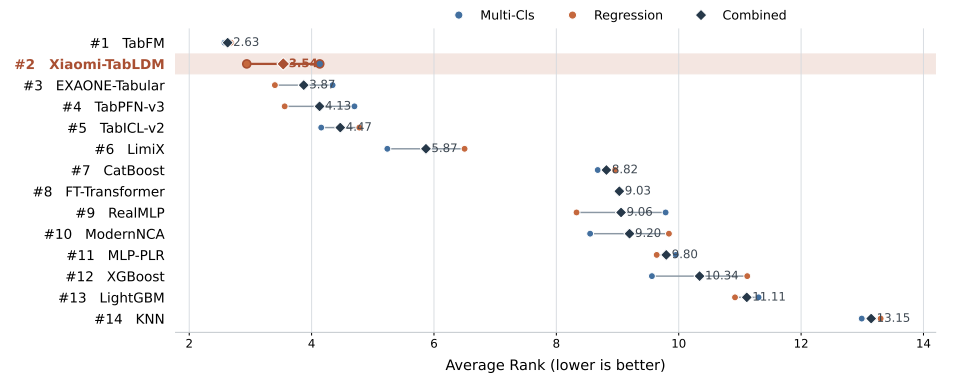
В регрессионной части TabArena, включающей 13 наборов данных, Xiaomi-TabLDM набрала 1900 очков Elo и уступила только TabFM с 2019 очками. В полном рейтинге из 51 набора данных модель заняла четвёртое место с 1659 очками — рядом с AutoGluon 1.5 (1662) и TabPFN-3 (1650). По данным разработчиков, этап обучения fit проходит на 82% быстрее, чем у TabFM, а предсказание — на 68% быстрее.
У модели есть и ограничения: время инференса квадратично растёт как с числом строк, так и с числом столбцов, поэтому увеличение таблицы может заметно повышать вычислительные затраты. Тем не менее Xiaomi-TabLDM предлагает альтернативу традиционному подходу, при котором для каждой табличной задачи приходится отдельно обучать модель, и доступна для использования и модификации под лицензией Apache 2.0.